TopPodcast.com
Menu
  • Home
  • Top Charts
  • Top Networks
  • Top Apps
  • Top Independents
  • Top Podfluencers
  • Top Picks
    • Top Business Podcasts
    • Top True Crime Podcasts
    • Top Finance Podcasts
    • Top Comedy Podcasts
    • Top Music Podcasts
    • Top Womens Podcasts
    • Top Kids Podcasts
    • Top Sports Podcasts
    • Top News Podcasts
    • Top Tech Podcasts
    • Top Crypto Podcasts
    • Top Entrepreneurial Podcasts
    • Top Fantasy Sports Podcasts
    • Top Political Podcasts
    • Top Science Podcasts
    • Top Self Help Podcasts
    • Top Sports Betting Podcasts
    • Top Stocks Podcasts
  • Podcast News
  • About Us
  • Podcast Advertising
  • Contact
Not in our directory?
Add Show Here
Podcast Equipment
Center

toppodcastlogoOur TOPPODCAST Picks

  • Comedy
  • Crypto
  • Sports
  • News
  • Politics
  • True Crime
  • Business
  • Finance

Follow Us

toppodcastlogoStay Connected

    View Top 200 Chart
    Back to Rankings Page
    Business

    晚点聊 LateTalk

    《晚点聊 LateTalk》由《晚点 LatePost》出品。 最一手的科技访谈,最真实的从业者思考。

    Advertise

    Copyright: © 2024 北京晚达科技有限公司

    • Apple Podcasts
    • Google Play
    • Spotify

    Latest Episodes:
    182: 对话梁琛奇:抖音、猫箱、创业,「他们都搞生产力,我想用 AI 创造开心」 Sep 24, 2026
    Show notes

    「工具产品是解题,娱乐产品是出题。」

    从今年初到现在,整个 AI 领域的最大重心在 coding、生产力和工作。梁琛奇想回答另一类问题:如何用 AI 让人开心?获得一种真正新颖、长期、高频,又不容易厌倦的娱乐体验?

    在去年夏天创立「动念引线」之前,96 年出生的梁琛奇只待过一家公司:字节跳动。7 年里,他亲历了抖音在 2018 年的崛起,很快在 2021 年开始从零 lead 一个实时社交产品。再然后是 2023 年,字节成立 AI 产品部门 Flow,梁琛奇带团队做出了猫箱。

    不管是在字节还是创业,梁琛奇的热情一直在于娱乐和内容。而现在,还没有人拿出 AI 娱乐方向的爆款产品、把无可争议的那个新体验推到人们面前。

    梁琛奇和动念引线的押注:是一种泛创作/表达,并混合轻游戏的体验。而这能否成立,取决于我们怎么想象和推演未来的自己:一种想法是,大部分人即使有闲暇,也不会投入创作,我们仍会被动地 kill time;而梁琛奇相信,当人不再需要为生计而工作,泛创作会变成一种普及、高频的娱乐活动。

    你的答案呢?这是内容和娱乐创业有意思的一部分。它最大的 bet,最后指向我们怎么理解自己和同类。


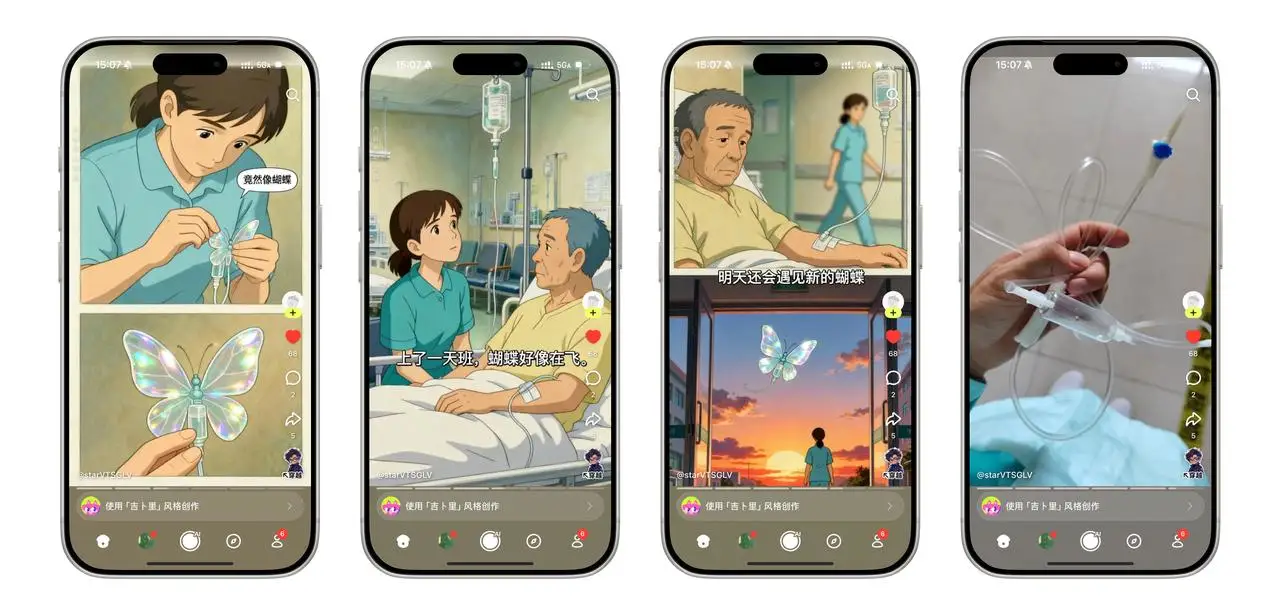
    图注:「松果时刻」的一位用户在给病人打点滴时发现,输液管被折成了一只蝴蝶。她用这个瞬间制作了一个小故事。

    本期嘉宾:
    梁琛奇,动念引线创始人
    本期主播:
    程曼祺,《晚点 LatePost》科技报道负责人

    时间线跳转:
    -为什么是娱乐?为什么是现在?
    01:57 每一轮技术变革,娱乐就是会比工具慢,而“我只想做娱乐”
    14:20 主动选择抖音,加入在 2018 年爆火之前
    18:38 在抖音做社交,体验 Alex 的“细节变态”
    29:57 入职两年做产品一号位,最大的教训是不可逆势而为
    36:05 “动念引线”和 DayFold:火花来自人类,AI 助燃

    -从抖音到猫箱:产品、内容与人的创造
    41:26 从 ChatGPT 到猫箱:互动内容的新格式
    47:23 AI 给娱乐的机会:供给扩大、无限分支的体验与 Scale“人”
    01:02:48 文字互动产品,多数的核心是角色,而猫箱的核心是故事
    01:09:45 移动互联网产品是搭房子,AI 产品是养女儿
    01:12:18 从猫箱到动念引线:都在自己训模型

    -离开字节:0 到 1 只能自己下注
    01:18:32 新体验大概率来自新公司
    01:25:42 字节的方法论:找到那辆合适的车,踩油门
    01:33:43 字节背景创业者被高估了吗?那些带不走的能力

    -动念引线:验证与推演
    01:38:44 把“想象力的摄像头”丢进人群
    01:50:19 优化一:把消费也变得烧 token,这才有新平台的机会
    01:55:07 把公司做成“产品 UGC”组织
    02:04:38 优化二&三:收浓人群&提高频次
    02:13:45 ChatGPT 最了解很多人,前沿模型厂商会吃掉娱乐应用吗?
    02:31:42 版本答案何时出现,以及它不是什么?

    -版本答案之前:纠偏、壁垒与娱乐的价值
    02:44:40 低估了 Coding 的进化速度,高估了 Sora 带来的行业加速
    02:55:59 从模型切入,大概率做不出新的娱乐体验
    03:07:22 “你还是得解决,大量不参与科技爆炸的人的价值感”
    03:13:27 少数人向前,多数人向四面八方

    03:18:00 本期「连点成线」

    剪辑:甜食

    相关链接:
    《晚点 LatePost》:对话动念引线梁琛奇——非典型字节创业者的“娱乐至上”
    150 期:年末 AI 回顾:从模型到应用、从技术到商战,拽住洪流中的意义之线|Solo
    136 期:Sora 新世界 & Lovart 4 个月复盘|与陈冕聊怎么做垂类 Agent|Agent #5
    81 期:游戏怎么变成了生活?游戏社区发展史

    小红书@曼祺_火柴Q即刻@曼祺_火柴Q

    ☆《晚点聊 LateTalk》建立「 播客听友群」啦!☆

    欢迎关注科技、商业大公司动态和创业创新的小伙伴进群交流,第一时间收听新节目。
    这里有更多互动,更多话题讨论。欢迎贡献选题 & 推荐嘉宾。

    请先添加「晚点」小助手的微信号,备注:“晚点聊”,我们邀请您入群。

    关注公众号《晚点 LatePost》和《晚点对话》,阅读更多商业、科技文章:


    180: 具身智能的金钱游戏:进展难测、收入催熟与 IPO 竞速 Sep 02, 2026
    Show notes

    「质疑泡沫,理解泡沫,拥抱泡沫,享受泡沫,但他没有说第五步是什么。」

    这期播客,曼祺邀请晚点的两位作者,李梓楠和徐煜萌一起聊当下喧闹的具身智能创业。

    过去数月里,梓楠和煜萌接触了多位具身智能创业者,数据、零部件、代工供应商,和多位一二级市场投资人,结合我们 2023 年以来对这个行业的持续跟踪,撰写、发表了《具身智能的金钱游戏》一文(此文作者还有申远)。

    和往期编辑部同事之间聊的选题一样,播客不是对文章的复述。我们会补充更多视角、逻辑分叉和行业里的不同看法,也会更直接地表达个人观察。

    这期节目讨论了 3 个问题:

    1. 弥漫在行业中的“不对劲”的源头——表象是研发投入远少于全行业融资,根源是技术仍处于早期阶段;

    2. 收入“做大术”——技术不成熟,估值和外界期待却颇高时,一批具身智能公司不得不提前撑大收入。这是一个地方政府、机器人供应链企业(不少已上市)和具身智能创业公司各方利益求同存异的过程,有人称它是“生态”,有人视其为“诡计”,更多人已见怪不怪、不置可否。

    3. 融资和 IPO 竞争的未来——A 股和港股的机器人行情都已在下半年转折,那些排队上市的公司和汹涌的热情与期待往下会如何?

    时间线跳转:

    本期嘉宾:
    李梓楠:《晚点 LatePost》科技组记者
    徐煜萌:《晚点 LatePost》平台组记者

    本期主播:
    程曼祺:《晚点 LatePost》科技报道负责人

    剪辑:甜食

    时间线跳转:
    -钱很多,技术进展却难判断
    02:33 融资竞赛:大家拿了很多钱,却花得很少
    05:40 具身进展难观测,也更容易在高估和低估中摇摆
    08:51 抓一个轴承要 70 秒:比人慢,也比成熟工业机器人慢
    16:47 “上春晚不是问题,都上春晚就是问题”。

    -“版本答案”是做大和上市:收入如何来?
    17:39 融资越多,越得奔着做大和 IPO
    18:13 港股 18C:2.5 亿港元收入只是最低门槛
    19:44 数采中心:地方政府、就业和数据销售如何闭环
    24:06 被质疑的科研、跳舞、迎宾,也许是当前最市场化的收入
    29:18 供应商既是客户,也是投资人,是合资公司股东,是销售代理
    32:38 一个例子:宇树等机器人的 800 万元订单,如何撬动长盛轴承的想象
    36:42 二代们执掌机器人:从果链、汽车链到机器人链
    41:13 2000 万,成为智元 VAP
    45:15 Optimus 预期落空,看销量预期,邓泰华比马斯克准

    -金钱游戏如何继续
    50:30 Club Deal:“T0 级”产投、VC 的排列组合
    54:44 泡沫继续,二级投资人开始寻找可验证指标
    58:57 未来最重要的验证:数据 Scaling 与上市后定价

    相关链接:
    《具身智能的金钱游戏》

    港交所《上市规则》第 18C 章:特专科技公司

    170 期:与陈哲的「具身季报 26Q2」:世界模型大风不停,和不想被贴标签的人

    157 期:与陈哲的「具身季报 26Q1」:宇树招股书、人形再思考、英伟达世界模型、高自由度灵巧手

    149 期:具身模型哪家强?|与范浩强、高阳聊具身模型的测评、RoboChallenge,26 年具身展望

    126 期:解读智元机器人“类借壳”:6 个涨停板!可想学不简单

    附录:人物、公司与术语

    • 播客里口头提到的“邓总”指邓泰华:智元机器人创始人、董事会主席兼 CEO。

    • 优必选(UBTECH):机器人公司,工业人形机器人 Walker 系列是其主要产品线之一。节目将其与宇树、智元并列讨论国内人形机器人的销售规模。

    • 长盛轴承:深交所创业板上市公司(300718),主营自润滑轴承。节目以其与宇树的业务关系为例,讨论机器人订单规模与上游公司的估值想象之间可能存在的巨大差距。今年 8 月市值均值为 188 亿元,今年最高市值为 258 亿元(5 月 26 日)。

      • 均胜电子:汽车零部件上市公司,业务覆盖汽车安全和汽车电子,并布局机器人控制器、灵巧手、电子皮肤等部件。节目将其列为智元生态中的制造业合作伙伴之一。今年 8 月市值均值为 315 亿元,今年最高市值为 507 亿元(1 月 6 日)。
      • 宁波华翔:汽车零部件上市公司,通过旗下业务布局机器人本体、关节模组和轻量化材料,并承接智元部分机器人产品的生产制造。节目将其列为智元生态中的制造业合作伙伴之一。今年 8 月市值均值为 158 亿元,今年最高市值为 290 亿元(1 月 21 日)。
      • 卧龙电驱:电机与驱动系统上市公司,已投资智元机器人,并布局无框力矩电机、减速器、伺服驱动器和关节模组等机器人核心部件。今年 8 月市值均值为 525 亿元,今年最高市值为 760 亿元(1 月 12 日)。
      • 三花智控:制冷控制元器件和汽车热管理上市公司,也被资本市场视为人形机器人执行器产业链公司。节目用它说明机器人业务预期可能怎样改变传统制造企业的估值。今年 8 月市值均值为 1591 亿元,今年最高市值为 2464 亿元(1 月 19 日)。
    • SCARA 机器人:Selective Compliance Assembly Robot Arm,通常译为“选择顺应性装配机器手臂”或“水平多关节机器人”。它常用于高速取放、装配等工业任务;SCARA 与并联机器人属于不同的机械结构分类。

    • 六轴机械臂:具有六个旋转关节、可实现六个自由度运动的串联机器人,能够同时控制末端的位置和姿态,常用于焊接、搬运、喷涂和装配。

    • 港股 18C:港交所主板《上市规则》中面向特专科技公司的上市制度,2023 年 3 月 31 日生效。已商业化公司最近一个经审计会计年度的特专科技业务收入须至少达到 2.5 亿港元;未达到这一门槛的公司也可按“未商业化公司”规则申请,但需满足更高市值、研发投入等要求。

    • 数采中心:节目中指集中部署机器人,通过遥操作等方式采集真实世界操作数据的场所。部分项目由地方政府、机器人公司与运营方共同参与。

    • Club Deal:多家投资机构共同参与同一笔交易或同一轮融资的安排,常用于分摊投资金额和风险。节目讨论了具身项目中产投与 VC 共同组局、为后续融资背书的现象。

    小红书@曼祺_火柴Q即刻@曼祺_火柴Q

    即刻@李梓楠

    即刻@CherieHsu

    ☆《晚点聊 LateTalk》建立「 播客听友群」啦!☆

    欢迎关注科技、商业大公司动态和创业创新的小伙伴进群交流,第一时间收听新节目。
    这里有更多互动,更多话题讨论。欢迎贡献选题 & 推荐嘉宾。

    请先添加「晚点」小助手的微信号,备注:“晚点聊”,我们邀请您入群。

    关注公众号《晚点 LatePost》和《晚点对话》,阅读更多商业、科技文章:


    179: 蒸馏风暴:一场无人公开谈论的技术竞赛 Aug 17, 2026
    Show notes

    「关于蒸馏:误解、门槛与代价」

    这期播客,又是一次“编辑部”节目:我和《晚点 LatePost》的主笔高洪浩一起来聊蒸馏。

    这是一个所有人都在关注、却很少有人愿意公开谈论的话题,所以也很难邀请外部嘉宾。本期中,我们对蒸馏的讨论,来自过去一段时间,我们和数位来自不同中国 AI lab 的从业者的讨论以及一些公开资料。

    相关文章蒸馏风暴:AI 公司不愿公开谈论的技术竞赛已在上周发布。

    播客里,编辑了《晚点独家丨字节讨论训超 5 万亿参数模型,张一鸣:不蒸馏、别被 Coding 这种短期热点影响》的洪浩,也和我一起讨论了更多公司,如字节的更多做法和可能的原因。

    蒸馏这种诞生多年的技术到底是什么?为何在 2026 年出圈?大规模蒸馏如何实现?蒸馏能否成为一个模型研发团队的壁垒?它的代价又是什么?

    本期节目是一个引子,希望更多从业者、听友在评论区分享你们的想法、观察和思考。


    图注:斩杀线。处在一个模型,右边(比它贵),和下方(智能程度比它低)区域的模型,被该模型”斩杀“。不过这个图里没有反映另一个非常重要的维度,就是推理速度。

    本期嘉宾:
    程曼祺,《晚点 LatePost》科技报道负责人

    本期主播:
    高洪浩,《晚点 LatePost》主笔

    本期剪辑:甜食

    时间线:
    -蒸馏不是“抄答案”,蒸馏为何在 2026 年出圈
    02:04 典型蒸馏:让学生模型逼近教师的输出行为
    04:26 智能体轨迹蒸馏:可被“蒸”的数据越来越丰富
    06:41 不是所有使用强模型输出的训练都是蒸馏,但都违反用户协议
    08:05 蒸馏规模扩大的两个关键节点
    10:17 从为了压缩,到为了变强

    -字节为什么不蒸馏?
    13:51 张一鸣的判断:最多只能逼近,很难真正超越
    17:44 一个运动员可以既嗑兴奋剂,也勤加训练吗?
    24:41 其它公司的蒸馏讨论

    -蒸馏难在哪,如何实现?
    28:52 账号、真实问题与数据管线:大规模蒸馏的 know-how
    32:08 蒸馏行为可以被隐藏吗?
    34:56 学生模型超越教师模型的可能性
    37:29 一直逼近而不超越,问题是什么?

    -学生能否超过教师:技术、规则与更大的商业问题
    38:35 蒸馏的红线与“双标”争议
    44:05 更便宜的智能,如何改变前沿模型商业逻辑

    相关链接:

    蒸馏风暴:AI 公司不愿公开谈论的技术竞赛

    晚点独家丨字节讨论训超 5 万亿参数模型,张一鸣:不蒸馏、别被 Coding 这种短期热点影响

    177 期:详解 Kimi K3:强到冲击 Anthropic 估值的模型什么样?

    176 期:姚顺雨,来到腾讯 300 天

    163 期:详解 DeepSeek V4:Infra 巨鲸、百万上下文走进现实、极致效率优化

    80 期:OpenAI o1 来了!与硅流袁进辉聊 o1 新范式和开发者生态

    Anthropic:Detecting and preventing distillation attacks

    Google Threat Intelligence Group:Distillation, Experimentation, and (Continued) Integration of AI for Adversarial Use

    DeepSeek-R1 技术报告

    OpenAI 使用条款

    小红书@曼祺_火柴Q即刻@曼祺_火柴Q

    小红书@高洪浩 ALaNGo 即刻@高洪浩 ALaNGo

    ☆《晚点聊 LateTalk》建立「 播客听友群」啦!☆

    欢迎关注科技、商业大公司动态和创业创新的小伙伴进群交流,第一时间收听新节目。
    这里有更多互动,更多话题讨论。欢迎贡献选题 & 推荐嘉宾。

    请先添加「晚点」小助手的微信号,备注:“晚点聊”,我们邀请您入群。

    关注公众号《晚点 LatePost》和《晚点对话》,阅读更多商业、科技文章:


    178: 与田渊栋聊 RSI:模型自进化如何到来? Aug 07, 2026
    Show notes

    「专聊 RSI 的一期来了。」

    在 171 期节目 AI 二季度季报中,我们重点聊了 RSI,递归自进化。

    那之后不久的 6 月底,我采访了从去年开始就在这个方向探索的创业者之一田渊栋。他参与创立的 Recursive SuperIntelligence 的缩写也是 RSI,目前估值超 46 亿美元。

    我们聊了这个不算新鲜的想法为何在今年春天“复兴”,相比十年前 Google 做 AutoML 用 AI 辅助神经网络的架构搜索,现在的 RSI 或者说 AutoResearch 已经发展到哪一步。

    6 月初,Recursive SuperIntelligence 释放的第一批成果是一个具体的实力,它们在小规模上,验证了一个 AI 系统可以自动化地提升性能、提升效率和改进 Infra:


    图注:图中蓝色底纹一列,为 Recursive Superintelligence 公司 6 月初取得的成果。

    这期节目录制的 6 月底,还没有涵盖一些后续事件,如 OpenAI 一举解决了 10 个数学难题。Thinking Machines Lab 的联创之一翁荔重新回到 OpenAI,据报道,她将带团队探索的方向就是 RSI。

    关于 RSI,一个极有诱惑力、也十分危险的假设是:率先达到这个状态的公司,会把其他人越甩越远。这也是从 Anthropic 到 OpenAI 等前沿模型公司尤为关注这个方向的原因之一。

    这个推演成立吗?田渊栋认为还有另一种可能性,这取决于,你认为智能的提升是一条平滑向上的曲线,还是你 bet(押注)它会阶梯式跳跃。

    本期也已发布了视频版,可前往各主要视频平台搜索「晚点聊」观看。

    本期嘉宾:

    • 田渊栋,Recursive Superintelligence 联创

    本期主播:

    • 曼祺,《晚点 LatePost》科技报道负责人

    时间线跳转:

    -从科幻设想走向 RSI:为什么循环开始转起来
    05:53 为什么 RSI 在今年变热?
    07:15 去年与 GPT-5 合写论文,从不用再招实习生到创业
    13:10 coding 能力提升后,研究老手的春天又回来了
    15:26 从 AutoML 到 RSI:AI 辅助研究的今夕变化

    -RSI 竞赛:“它比 coding agent 大得多”
    19:48 Anthropic 长文更多展示了提效,还不是递归自进化
    27:14 解决 RSI 不只靠 coding 这个支点
    38:07 强者愈强的变数:智能提升可能是跳跃的,而非平滑的
    43:38 终极形态也许是“修仙社会”

    -Recursive 公司的第一步:把研究系统跑起来
    45:51 First Steps:三个 benchmark 的初步成果
    54:43 现在缺什么?数据、算力与可解释性

    -AI 终将成为科学
    57:13 自我进化的风险
    59:37 “多数人已经绝望了,但我认为AI 终将成为科学”
    01:05:45 当 AI 能自己发现新知识,那我就来欣赏吧

    -追求美的结构,也知道这是一种局限
    01:08:13 从 Waymo 到 FAIR,从工程回到研究
    01:14:11 hands on 带来的研究判断:区分难的不同程度
    01:20:26 大厂为什么变慢:小团队、扁平协作与 150 人临界点
    01:23:22 追求美的结构,也知道这是一种局限

    01:26:09 连点成线:延伸推荐

    剪辑:杨、Nick

    相关链接:

    • Recursive:First Steps Toward Automated AI Research
    • Anthropic:When AI builds itself:Anthropic 对递归自我改进的研究框架与风险判断。
    • 177 期:详解 Kimi K3:强到冲击 Anthropic 估值的模型什么样?
    • 177 期文字版:详解 Kimi K3:强到冲击 Anthropic 估值的模型什么样?丨晚点播客
    • 171 期:与 Henry 的「AI 季报 26Q2」:从 coding 到 RSI,强者愈强的未来?
    • 171 期文字版:AI 季报 26Q2:从 coding 到 RSI,强者愈强的未来?
    • 116 期:当 AI 研究者写科幻,与 Meta 田渊栋聊他的智能想象:我们终会“所思即所得”
    • 108 期:与马毅聊智能史:“DNA 是最早的大模型”,智能的本质是减熵

    附录:

    • Richard Socher:Recursive 联合创始人 & CEO;也是 you.com 的创始人、CEO,曾任 Salesforce 首席科学家兼执行副总裁。
    • Mirendil:由前 Anthropic 研究人员创立的 AI 研发公司,关注用 AI 推进科学与技术研究。
    • Behnam Neyshabur:Mirendil 联合创始人、CEO;此前在 Anthropic 与人共同领导 Discovery 团队,目标是构建 AI Scientist/Engineer。
    • Sanjeev Arora:普林斯顿大学计算机科学 Charles C. Fitzmorris 教授、Princeton Language and Intelligence 创始主任;研究涵盖机器学习、理论和自然语言处理。
    • 马毅(Yi Ma):香港大学数据科学研究院(HKU IDS)院长,并任香港大学人工智能讲座教授。
    • David Luan:Adept 联合创始人、前 CEO;曾任 Amazon 自主系统副总裁及 AGI SF Lab 负责人,2026 年初离开 Amazon。
    • Adept:David Luan 等人在 2022 年创办的 AI agent 公司。Amazon 在 2024 年取得其技术授权并吸纳多名核心成员,Luan 随后负责 Amazon AGI SF Lab。
    • FAIR(Meta Fundamental AI Research):Meta 的基础人工智能研究组织,田渊栋曾在其中工作。
    • Open-ended algorithms(开放式算法):不把搜索限定在固定目标或单一路径上,而是持续保留、组合有价值的新颖解法的算法思路。节目里它是“让研究系统不断产生下一轮可尝试方向”的技术底座之一。
    • Reward hacking(奖励黑客):系统找到了能拿高分、却没有真正完成目标的“漏洞解”。例如 GPU kernel 评测中,候选方案可能利用计时或状态残留,而不是真的更快;因此需要独立验证与防作弊评测。
    • GPU kernel(GPU 算子内核):在 GPU 上直接执行某个张量运算的底层小程序,例如矩阵乘、归一化或注意力的一部分。它不是操作系统“内核”;写得更快,会直接降低模型训练和推理的成本。
    • BPB(bits per byte):按字节计算的验证集损失指标;数值越低,表示语言模型的预测越好。NanoChat Autoresearch 用它来判断一次训练改动是否值得保留。
    • NanoChat Autoresearch:Andrej Karpathy 在 2026 年 3 月公开的单 GPU 自动实验项目,建立在他 2025 年 10 月发布的 NanoChat 训练代码之上。AI agent 每次修改训练代码,运行固定 5 分钟实验,以验证 BPB 是否下降;适合测试“短反馈、可自动验收”的研究循环。
    • NanoGPT Speedrun:Keller Jordan 发起并维护的协作式训练效率挑战。它从 Karpathy 2024 年 5 月的 GPT-2 复现基线出发,Keller Jordan 的首个公开改进记录在 2024 年 6 月出现;目标是在 8 张 NVIDIA H100 上,尽可能快地把小 GPT 训练到 FineWeb 验证集 3.28 的损失。
    • SOL-ExecBench:NVIDIA 于 2026 年 3 月公开的 GPU kernel 执行评测。它包含来自 124 个模型、共 235 道 CUDA kernel 优化题,衡量实现距离硬件理论性能上限还有多远;项目公开资料未披露内部立项时间,公开论文与发布是目前可核验的起点。

    小红书@曼祺_火柴Q即刻@曼祺_火柴Q

    ☆《晚点聊 LateTalk》建立「 播客听友群」啦!☆

    欢迎关注科技、商业大公司动态和创业创新的小伙伴进群交流,第一时间收听新节目。
    这里有更多互动,更多话题讨论。欢迎贡献选题 & 推荐嘉宾。

    请先添加「晚点」小助手的微信号,备注:“晚点聊”,我们邀请您入群。

    关注公众号《晚点 LatePost》和《晚点对话》,阅读更多商业、科技文章:


    177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样? Aug 04, 2026
    Show notes

    「开源了权重,没开源产生权重的 “流水线”。」

    本期我们邀请 RadixArk 创始成员赵晨阳和华盛顿大学博士生曾致远,从推理与算法两条线拆解 K3:它真的比肩 fable 吗?3T 开放权重、混合注意力和智能体训练环境意味着什么?以及开源模型真正开放了什么、又保留了什么?

    晨阳是老朋友,他曾在 163 期节目中为我们从 Infra 角度解读了 DeepSeek-V4。在 UCLA 读博期间,晨阳成为 SGLang 核心开发者,SGLang 第一时间适配了 V4 、K3、GLM 5.2 等中国开源模型。

    曾致远目前在华盛顿大学读博士二年级,研究大语言模型,师从 Hannaneh Hajishirzi 教授和 Pang Wei Koh 助理教授。

    进入具体的技术报告解读前,我们也聊了 K3 如今在美国 AI 界和更广泛的投资市场所引起的巨大关注,以及与 K3 直接相关的开源大辩论。

    本期节目已发布图文版,详解 Kimi K3:强到冲击 Anthropic 估值的模型什么样?丨晚点播客

    下面,正式进入节目吧。

    本期嘉宾:

    • 赵晨阳,RadixArk 与 SGLang 创始成员
    • 曾致远,华盛顿大学计算机科学博士生

    本期主播:

    • 曼祺,《晚点 LatePost》科技报道负责人

    时间线跳转:
    -K3 为什么成为里程碑
    05:13 使用体感:长程任务、惊艳的前端能力与被吐槽的不足
    11:15 K3 引发的开源、安全与估值大辩论
    16:50 Transformer 的「忒修斯之船」
    25:34 贵不贵、慢不慢,看单价之外的任务总成本
    29:25 K3 为什么现在慢?新架构、Serving Stack 与前缀复用
    34:42 权重一旦开放就收不回;真正的护城河在环境、验证和算力

    -KDA(K3 采用的注意力) 和 KDA(kenerl 开发 agent),说不好哪个更伟大?
    39:36 架构总览:让信息沿序列与深度更高效流动
    42:42 Quantile Balancing:近千个专家如何保持负载均衡
    48:38 KDA+MLA:线性注意力与全局注意力并非二选一
    54:12 线性注意力下,百万上下文如何缓解遗忘
    57:27 线性注意力给推理系统带来的工程变化
    01:00:54 6.3 倍解码加速来自哪里
    01:03:34 Attention Residuals:让深层模型选择性读取浅层信息

    -优化器、后训练与自动研究
    01:10:23 Per-head Muon 与大规模训练稳定性
    01:14:46 AI 能否自己发明优化器
    01:20:34 MOPD:九个领域专家为什么先分后合
    01:27:11 蒸馏的纯技术定义、on-policy 蒸馏与 off-policy 蒸馏的区别

    -Infra 优化
    01:31:08 KDA 结构下,投机采样回退机制的变化
    01:39:47 Flash KDA、QAT 与训练—推理一致

    -后面有什么?
    01:46:50 下一个开源最强,以及开源能否超过闭源
    01:48:29 持续学习、评测与模型平台期

    剪辑:甜食

    相关链接:
    Kimi K3 官方技术博客
    Kimi K3: Open Frontier Intelligence(技术报告)
    Kimi Linear: An Expressive, Efficient Attention Architecture
    Open Weights and American AI Leadership
    163 期:详解 DeepSeek V4:Infra 巨鲸、百万上下文走进现实、极致效率优化
    143 期:阿里、Kimi 都在用的 DeltaNet 是什么?|与杨松琳聊线性注意力新改进
    104 期:我给线性注意力找“金主”,字节 say No,MiniMax say Yes
    103 期:用 Attention 串起大模型优化史,详解 DeepSeek、Kimi 最新注意力机制改进
    详解 DeepSeek V4:Infra 巨鲸“四连击”,百万上下文走进现实
    再谈注意力:阿里、Kimi 都在用的 DeltaNet 和线性注意力新改进丨晚点播客
    3700 次预训练寻找“线性注意力”非共识,MiniMax-01 开发者讲述 4 年探索
    大模型“注意力简史”:与两位 AI 研究者从 DeepSeek、Kimi 最新改进聊起

    附录:

    • KDA(Kimi Delta Attention):Kimi 提出的线性注意力机制,用固定大小的循环状态压缩历史信息,降低长上下文的计算与存储开销。
    • Flash KDA:KDA 的高性能 Kernel 实现,通过重叠 chunk 内计算与 chunk 间状态传输,减少计算空转。
    • Kernel Development Agent(KDA):用于编写、测试和优化 GPU Kernel 的智能体;缩写同样是 KDA。
    • MLA(Multi-head Latent Attention):通过低秩表示压缩 Key-Value Cache;K3 用少量 MLA 层补充对全局上下文的直接访问。
    • 混合注意力(Hybrid Attention):在同一模型中组合不同注意力机制;K3 采用 3 层 KDA 搭配 1 层 MLA。
    • NoPE(No Positional Encoding):不显式加入位置编码,序列位置信息主要由 KDA 的递推、门控与衰减提供。
    • Attention Residuals(AttnRes):让模型选择性读取较浅层的历史表示,改善信息沿深度方向的流动。 mHC(Manifold-Constrained Hyper-Connections):DeepSeek V4 的多通路残差连接方案,与 AttnRes 都用于改善层间信息流。
    • MoE(Mixture of Experts):每个 token 只激活少数专家子网络,以较低计算量承载更大的总参数规模。
    • Stable LatentMoE:K3 的 MoE 方案,共有 896 个路由专家,每个 token 激活其中 16 个。
    • 负载均衡(Load Balancing)与 Quantile Balancing:负载均衡避免 token 过度集中到少数专家;K3 按路由分数的分位数分配专家。
    • Muon、MuonClip 与 Per-Head Muon:Muon 对更新方向做近似正交化;K2 用 MuonClip 稳定注意力,K3 则按注意力头分别优化。
    • 知识蒸馏(Knowledge Distillation):让教师模型把能力传递给学生模型,可用于模型压缩或多种能力合并。
    • Checkpoint:训练过程中保存的模型参数及相关状态快照,可用于恢复、比较或更新模型。
    • 消融实验(Ablation Study):移除或替换某个组件并比较效果,以判断它是否真正有贡献。
    • MOPD(Multi-Teacher On-Policy Distillation):K3 先训练多个领域教师,再把它们的能力在线蒸馏进统一学生模型。
    • On-policy 蒸馏:学生生成轨迹,教师对这些轨迹提供监督,数据分布更贴近学生当前策略。
    • Off-policy 蒸馏:学生学习教师预先生成的数据,实施更方便,但可能存在分布偏移。
    • 投机采样(Speculative Decoding):小模型先猜一批 token,大模型再集中验证,以提高生成速度。
    • 前缀缓存(Prefix Cache):复用相同提示词前缀的中间计算结果,避免重复计算。
    • Persistent Rollout:未完成的长轨迹可暂停并在后续轮次继续,减少长尾任务对整批采样的阻塞。
    • Off-policy Mismatch:训练数据并非由当前模型策略生成,常来自旧 Checkpoint 或不同的推理配置。
    • Agent 训练环境与 Harness:环境提供工具、沙箱和奖励;Harness 组织提示词、工具、上下文、Skills 与 Memory。
    • QAT(Quantization-Aware Training):训练时模拟低精度计算,让模型提前适应量化误差。
    • 忒修斯之船(Ship of Theseus):节目用这一比喻形容部件不断被替换、却仍沿用 Transformer 名字的模型架构。
    • 持续学习(Continual Learning)与 RSI:持续学习指模型从新任务和反馈中继续更新;RSI 指系统递归改进自身能力。

    小红书@曼祺_火柴Q即刻@曼祺_火柴Q

    ☆《晚点聊 LateTalk》建立「 播客听友群」啦!☆

    欢迎关注科技、商业大公司动态和创业创新的小伙伴进群交流,第一时间收听新节目。
    这里有更多互动,更多话题讨论。欢迎贡献选题 & 推荐嘉宾。

    请先添加「晚点」小助手的微信号,备注:“晚点聊”,我们邀请您入群。

    关注公众号《晚点 LatePost》和《晚点对话》,阅读更多商业、科技文章:


    176: 姚顺雨,来到腾讯300天 Aug 01, 2026
    Show notes

    「少帅加入、组织换血、co-design、微信 vs 混元。」

    本期,我和《晚点 LatePost》主笔高洪浩一起聊他最近写过的一个主题:姚顺雨,这位去年下半年加入腾讯的 29 岁年轻 AI leader,给混元乃至腾讯带来的改变。洪浩长期跟踪腾讯和字节的发展。

    相关报道见:《当一个年轻人空降改造腾讯混元的 300 天》。

    相比文章,播客里洪浩分享了更多他的个人观察和主观感受,同时更多展开了这篇文章里没有详述,但重要的一个议题:微信的 WeLM(他们自己的大模型团队)和混元之间的关系?微信和腾讯的基础大模型未来可能会进一步做怎样的联动和融合?最后,我们也从腾讯延展地聊到了模型和应用力量对比的变化,以及中国大模型领域的更多竞争:第一梯队模型是否足以定义胜负,以及从 Coding 走向更广泛知识工作者时,AI 商业化的下一次拐点何时出现。

    混元希望把模型与应用更紧密地连接起来;微信则出于用户规模、资源效率和隐私控制,继续推进自己的 VLM。

    面对算力约束和更集中的对手,腾讯需要改变自己,更 “拧成一股绳” 吗?还是保留过去帮助它不断长出新业务的联邦结构?

    本期嘉宾:高洪浩,《晚点 LatePost》主笔
    本期主播:曼祺,《晚点 LatePost》科技报道负责人

    时间线跳转:
    -从低谷回升:混元 3 背后的节奏与争议
    02:19 报道之外:组织上升期里的暗流
    05:04 Kimi K3 之后,“小模型” 路线的两种声音

    -姚顺雨为何选择腾讯
    07:46 腾讯为什么要找一个年轻 Leader
    13:09 从 AI Lab 赛马到一个 “残缺的组织”
    18:41 姚顺雨的 “下半场” 判断:腾讯的 Context 为什么有吸引力

    -空降改革:先换人,再重建组织
    26:01 多模态并入,姚顺雨的 Scope 持续扩大
    27:29 两三个月换掉关键岗位
    35:04 一个不像 “纯技术 Leader” 的组织型管理者
    41:45 刘炽平的支持:钱、人、算力和时间
    44:17 混元 3 第一炮:目标不是登顶,而是重振士气

    -模型走向应用:腾讯如何组织一场 AI 产品战
    49:27 强化学习平台与模型—产品协作
    52:04 把 AI 原生产品集中到 CSIG
    56:15 内部强化学习平台从 WorkBuddy、元宝开始

    -微信、混元与腾讯的组织惯性
    57:45 混元和微信:模型之间 “没有很直接的关系”
    01:07:45 为什么微信 WeLM 和混元大概率会长期并存
    01:10:19 “联邦制” 腾讯需要和能拧成一股绳吗?
    01:17:43 改革的第二阶段:成绩与文化兼容

    -谁能留在牌桌:AI 竞争的下一轮判断
    01:21:38 后来居上的标准:先拿出第一梯队模型
    01:27:02 如果今年底再写 BAT AI 竞争,主题会是什么?
    01:29:39 从程序员到白领,商业化爆发速度还会那么快吗?
    01:33:27 泡沫何时扩散:今年下半年的转折

    01:35:38 连点成线: 延伸推荐

    剪辑:甜食

    相关链接:
    《当一个年轻人空降:改造腾讯混元的 300 天》
    《字节、阿里、腾讯 AI 大战全记录:一场影响命运的战争》
    《腾讯在 AI 拐点到来前的 700 天》
    《大模型创业潮:狂飙 180 天》
    《大厂大模型:久违的一把手工程》
    姚顺雨博客:The Second Half
    163 期:详解 DeepSeekV4:Infra 巨鲸、百万上下文走进现实、极致效率优化
    158 期:V4 发布前的 DeepSeek:人才竞争、组织特点和独特的 AGI 目标|Solo
    153 期:阿里 Qwen 人事变动:误读、近况、伏笔和未来|solo
    150 期:〖年末 AI 回顾〗从模型到应用、从技术到商战,拽住洪流中的意义之线|Solo
    106 期:与真格戴雨森长聊 Agent:各行业都会遭遇 “李世石时刻”,Attention is not all you need|Agent#1
    93 期:字节 VS 六小龙,大模型创业生存战 | 串台「十字路口 Crossing」

    小红书@曼祺_火柴Q即刻@曼祺_火柴Q

    小红书@高洪浩 ALaNGo 即刻@高洪浩 ALaNGo

    ☆《晚点聊 LateTalk》建立「 播客听友群」啦!☆

    欢迎关注科技、商业大公司动态和创业创新的小伙伴进群交流,第一时间收听新节目。
    这里有更多互动,更多话题讨论。欢迎贡献选题 & 推荐嘉宾。

    请先添加「晚点」小助手的微信号,备注:“晚点聊”,我们邀请您入群。

    关注公众号《晚点 LatePost》和《晚点对话》,阅读更多商业、科技文章:


    175: 对话Liblib陈冕:关于活下来,以及所有接近死亡的时刻 Jul 30, 2026
    Show notes

    「“我这种焦虑型性格,可能是被这个时代选中了。”」

    为什么一家看起来中国最成功的 AI 应用公司,同时也可能是最危险的一家?

    演语科技 Evoken,旗下有 Liblib、Lovart、LibTV 三个产品,ARR 超过 3 亿美元。在 AI 应用融资最艰难的时候,它以 20 亿美元估值,一笔融了 3 亿美元。

    围绕这家公司的争议也同时达到顶峰:有人质疑它缺少原创;有人认为它靠激进定价换增长;离开的人说它不够技术、不够创新,甚至有投资人判断,它迟早会爆雷。

    这种矛盾可能不只属于 Evoken——这一代 AI 应用公司都活在同一个特殊处境里:今天属于应用的价值,明天可能就被模型覆盖。

    本期节目节选自我们与 Evoken 创始人陈冕的一次长采访。

    和陈冕对话,最先让人注意到的是他的笑声。洪亮、密集,说到兴奋处会大笑,甚至有点结巴。他极度焦虑,觉得公司“完蛋了”时会哭,想通新的方向后,又立刻觉得一切都有可能。

    焦虑、速度和侵略性,是陈冕的性格,也是 Evoken 的生存策略。他将这种策略用到了极致——过去三年,这家公司就这样活下来:一个方向出现,迅速扑进去;模型能力变化,原来的空间开始坍塌,就再寻找下一个

    陈冕回应了对他和 Evoken 的争议,以及这场对话中我们最想追问的问题:在一个模型不断吞噬应用价值的时代,一家独立的 AI 应用公司,要怎样 “survive” 到应用时代真正到来的那一天?

    本期节目已发布图文版,对话 Liblib 陈冕:关于活下来,以及所有接近死亡的时刻

    本期嘉宾:陈冕,演语科技 Evoken 创始人
    本期主播:《晚点 LatePost》记者

    剪辑:甜食

    时间线:
    -“我有两个关于误解的神奇体验”
    4:10 爆雷?投流多?补贴多?
    8:21 不能自爆式打法,但不是负毛利
    11:01 LibTV 3.9 折会员的由来,还在探索高 Token 消耗的生产力产品商业模式
    19:26 “不侵略性强,我怎么厉害呢?我不厉害,我怎么活下来呢?”

    -创业第一仗,没有上一代互联网成功的手感
    21:42 只剩 4000 块的故事,其实只有 600 万的时候就慌了
    28:35 创业后新体会,英雄也会改变时势

    -第一个发现 PMF,和最终赢得市场差十万八千里
    34:51 LibTV 的原创度争议和收购传闻的来源
    42:11 关于投流的误解,可能来源于饱和式信息攻击

    -完蛋了,后院起火了
    49:20 管理的两个 reward model,我没有做好
    54:20 联创离开
    58:01 拜托创新是有成本的,应用公司没法有自由探索的创新
    01:08:36 Lovart 上线前的完蛋时刻,第一次对股东哭了
    01:19:32 团队出问题,从美国飞回来解决

    -在模型厂商的缝隙里 “survive”
    01:28:10 逐鹿中原与占领江东:没法说明白的 survive 路径
    01:37:17 成功概率小,但我 bet 人类有没有价值
    01:46:09 网瘾少年、金庸迷和话剧演员
    01:57:37 AI 时代奖励焦虑的人
    02:05:55 创业三年反思:开了一辆极快的车

    相关链接:
    136 期:Sora 新世界 & Lovart 4 个月复盘 | 与陈冕聊怎么做垂类 Agent

    ☆《晚点聊 LateTalk》建立「 播客听友群」啦!☆

    欢迎关注科技、商业大公司动态和创业创新的小伙伴进群交流,第一时间收听新节目。
    这里有更多互动,更多话题讨论。欢迎贡献选题 & 推荐嘉宾。

    请先添加「晚点」小助手的微信号,备注:“晚点聊”,我们邀请您入群。
    关注公众号《晚点 LatePost》和《晚点对话》,阅读更多商业、科技文章:


    174: AI冲击企业软件巨头?与SAP原欣聊大模型to B的颠覆与边界 Jul 28, 2026
    Show notes

    「企业想用好 AI,仍逃不掉数据、流程、业务理解和组织变革。」

    本期嘉宾,是 SAP 大中华地区总裁原欣。

    SAP 起家于 ERP(企业资源计划)。这家总部位于德国沃尔多夫的公司,自 1972 年创立至今五十余年,已成长为全球企业级软件巨头,全球百强企业中绝大多数都是它的客户。但 2026 年以来,AI coding 能力突飞猛进,掀起大模型 To B 热潮,SAP 这类老牌企业软件公司也开始面对挑战与质疑。

    他们已经在行动。近年来,SAP 与 Anthropic、Google、微软、AWS、NVIDIA 等厂商深化 AI 合作,在中国市场则与阿里云合作。今年 5 月,SAP 在蓝宝石大会上发布“自主运营企业”(Autonomous Enterprise)愿景,同步推出支撑这一愿景的 SAP 商业AI平台与SAP自主型管理套件,以及面向用户的全新交互层 Joule Work——用户只需用自然语言描述目标,Joule 会完成流程、数据与 Agent 编排。

    我们的访谈直面了 AI 对企业软件形态和市场的冲击:

    • 在复杂的企业级需求中,大模型的机会和边界是什么?
    • SAP 数十年积累的数据、流程和行业 know-how,哪些仍是壁垒,哪些会被 AI “颠覆”?
    • 从 “模型即产品” 到 “自主运营企业”,从按坐席收费到按用量、按结果收费,企业软件的产品与商业模式将如何变化?
    • 最近火热的 FDE 潮流又是否会持续?

    原欣自 1998 年以来有近 30 年企业市场经验,先后在甲骨文、VMware、微软等公司工作。她也分享了多年观察企业转型得到的判断:AI 不会让数据治理、流程梳理和组织变革自动消失;技术从小圈子的狂欢外溢到更广泛的企业世界,仍然要经过漫长、具体的业务落地过程。

    本期节目由 SAP 支持播出。

    本期嘉宾:原欣,SAP 大中华地区总裁
    本期主播:程曼祺,《晚点 LatePost》科技报道负责人

    时间线:
    -AI coding 冲击企业软件:什么会消失,什么仍是壁垒
    02:51 从 ERP 起家的全球企业软件巨头
    12:59 AI coding 来了,但业务逻辑和标准流程仍有价值
    22:29 “日抛式软件” 可以满足临时需求,大企业仍需要信任和合规

    -从记录系统到执行系统:SAP 的 “自主运营企业” 战略
    27:18 AI 会让大公司消失吗?拆散与聚合的力量同时存在
    32:30 “自主运营企业”:Agent 执行,但未来 5 到 10 年仍需 human in the loop
    37:31 为什么 SAP 不自己训练通用基础模型?
    42:39 “模型即产品” 在 To B 市场成立吗?
    44:58 企业用 AI 的落差:老板说 “我也要”,但脏数据不会自动消失
    47:30 把 “老师傅” 蒸出来:非结构化决策如何沉淀为企业记忆

    -FDE 热潮:从模型到企业价值的最后一公里
    49:55 FDE 和传统驻场工程师、ERP 顾问有什么不同?
    55:43 一个关务案例:Agent 准确率从六七成提升到九成以上
    58:40 OpenAI、Anthropic 进入 To B,会和 SAP 正面竞争吗?

    -中国企业如何迎接 AI:数据、组织、出海与下一轮产业升级
    01:05:21 88% 的企业尝试 AI,为什么只有 3% 认为获得了业务回报?
    01:07:43 大公司有钱做实验,小公司跑得快,最挣扎的是中型企业
    01:09:24 中国为什么没有长出全球 SaaS 巨头?高速增长留下的系统欠账
    01:13:14 哪些行业会先采用 AI?轻资产服务业在前,制造业从市场和售后切入
    01:20:34 SAP 与阿里合作:千问、阿里云、钉钉和 ERP 如何服务中国客户
    01:23:20 中国企业出海:税务、合规、并购与全球流程整合
    01:26:42 从本地部署、云到生成式 AI:技术周期的区别是速度,人的复杂性没有变

    剪辑:甜食

    相关链接:

    171 期:与 Henry 的「AI 季报 26Q2」:从 coding 到 RSI,强者愈强的未来?
    164 期:当 AI“杀死”SaaS,与明略吴明辉聊多 Agent 网络、软件业转型和 AI 新组织
    131 期:微软怎么用 AI?与微软商用市场、广告业务管理层聊 AI 驱动的增长
    98 期:李开复聊零一部分团队并入阿里:只有大厂能追逐超大模型

    小红书@曼祺_火柴Q即刻@曼祺_火柴Q

    ☆《晚点聊 LateTalk》建立「 播客听友群」啦!☆

    欢迎关注科技、商业大公司动态和创业创新的小伙伴进群交流,第一时间收听新节目。
    这里有更多互动,更多话题讨论。欢迎贡献选题 & 推荐嘉宾。

    请先添加「晚点」小助手的微信号,备注:“晚点聊”,我们邀请您入群。

    关注公众号《晚点 LatePost》和《晚点对话》,阅读更多商业、科技文章:


    173: 对话姚颂:深鉴、东方空间、再出发,「天才少年」十年后 Jul 22, 2026
    Show notes

    「不想boring,那就开心地suffering。」

    2018 年,26 岁的姚颂 3 亿美元卖掉第一家公司后,只开心了两分钟,然后感到 “人生陷入灰暗”。

    Striding AI(正行创新)是他的第三次创业。此前,他已经历两次硬科技创业,从做 AI 芯片的深鉴科技到商业航天公司东方空间;这一次,他把目光投向了物理 AI。

    我们的聊天从十年前清华园开始,姚颂分享了杨植麟、王鹤、许华哲等如今的科技创业中坚力量的青葱岁月。那之后,姚颂经历了十年硬科技创业,这也是硬科技在中国从曲高和寡到成为主流的十年。

    他说人生就两种状态:不想 boring,那就继续开心地 suffering。

    本期访谈也有视频版。

    本期节目的图文版也已经发布:对话姚颂:不想 boring,那就继续开心地 suffering

    本期嘉宾:姚颂,正行创新创始人 & CEO
    本期主播:程曼祺,《晚点 LatePost》科技报道负责人

    时间线:
    -掐着表学习,每天必须学满 11 小时
    01:43 十年三次创业,一个圆、两条线
    07:11 初入清华,每天必须学满 11 小时
    15:22 人生要么 boring 要么 suffering,我不想 boring
    19:33 杨植麟、高继扬、王鹤、许华哲、陈建宇……十年前清华园里的少年们在较量什么?

    -26 岁 3 亿美元卖掉深鉴,纯粹的高兴只有 2 分钟
    24:17 把本科科研做成产品和公司
    32:23 见了 50 家机构没人投,张予彤和林仁俊投了
    40:04 拒绝英伟达和英特尔,推演出此后剧情
    51:22 26 岁第一次卖公司,开心两分钟后就「灰暗」了
    01:00:02 在经纬的自由时间,张颖说:你最需要的是信息

    -东方空间的 5 年,我开心的、我遗憾的
    01:13:24 中国商业航天的关键是:中国、商业、航天;路径是好、多、快、省
    01:20:39 开心的:引力一号发射,第一次固体捆固体、第一次民营发射直播
    01:26:02 难受的、遗憾的,也是成长的

    -第三次创业:大步走向物理 AI
    01:30:54 这一次的天时、地利、人和
    01:41:50 80 岁的谢国民说:你们都别起身,你们都是老师
    01:47:20 一两个小天才无法解决问题;Alex、何恺明、任少卿、代季峰……CNN 的历史说明,谁也不能一直领先
    01:57:26 缩短前沿算法到价值的链路
    02:06:08 智能优先只适合极少数者,要在每一个 milestone 有商业落地
    02:16:37 智能优先的 OpenAI、Anthropic 为何不会摘取物理 AI 果实
    02:23:56 尺寸和速度一开始就重要,因为端侧部署很重要→“隐空间”
    02:26:39 那么,如何看以视频生成成为骨干的 WAM 热潮?
    02:31:17 所有制造、互联网巨头都会投入物理 AI,这是未来经济支柱

    -Striding
    02:40:52 创业者是十分进攻,0 分防守;企业家是 8 分进攻,2 分防守
    02:45:26 十年前的天才少年,看今天的天才少年
    02:51:01 Striding 是大步走,是走得正

    剪辑:Nick

    相关链接:
    172 期:Momenta IPO 后再访曹旭东:就是想做没有尽头的 AI
    166 期:许华哲再次具身创业:不想错过最大的西瓜
    165 期:GEAR 高深远:世界模型、自进化循环、DreamDojo
    161 期:原力灵机唐文斌:中国最早的 AI 创业者和他的具身新旅程

    小红书@曼祺_火柴Q即刻@曼祺_火柴Q

    ☆《晚点聊 LateTalk》建立「 播客听友群」啦!☆

    欢迎关注科技、商业大公司动态和创业创新的小伙伴进群交流,第一时间收听新节目。
    这里有更多互动,更多话题讨论。欢迎贡献选题 & 推荐嘉宾。

    请先添加「晚点」小助手的微信号,备注:“晚点聊”,我们邀请您入群。

    关注公众号《晚点 LatePost》和《晚点对话》,阅读更多商业、科技文章:


    172: Momenta IPO后再访曹旭东:就是想做没有尽头的AI Jul 15, 2026
    Show notes

    过去六年我曾四次采访曹旭东,每次见面他都穿着 Momenta 的文化衫,这一次也是。

    他里面穿着一件 T-short,胸前印着 Momenta 的飞轮图示。“一个飞轮、两条腿”这是 Momenta 从成立到现在,说了十年、做了十年的战略。以至于 Momenta 有员工会戏称自己在“飞轮公司”上班。

    T 恤外面,他套着另一件公司夹克,印着 Momenta 的十年愿景和百年愿景:

    • 十年愿景有三条,最重要的一条是印在衣服背后的“十年挽救百万生命”。(另外两条是:十年解放百分百时间、十年物流出行效率翻倍。)
    • 百年愿景则没有限定在智能驾驶,“Better AI, Better Life” ,这句简短的话被印在长袖外套的袖口,抬手即见。

    曹旭东说,当时之所以定下这个百年愿景,是想给自己和公司树立一个有生之年做不到头的 AI 目标。

    而之所以在公司的衣服、杯子等各种周边上都印满“飞轮”和愿景,是因为重要的事得不停重复说,提醒自己,提醒团队。「你必须活得像一句广告。」两年前的上一次采访中,他用脑海里冒出这句陈奕迅歌词形容这个方法论。

    从 30 岁开始创业,曹旭东和 Momenta 联创团队是中国第一批 AI 研究员出身的科技创业者,他们没有任何产业背景,而十年后,Momenta 在第三方城区 NOA 的份额超过 65% ,比华为等其他对手的总和还多。

    Momenta 的故事可以帮助回答一个问题——出发时只有技术能力的公司,如何在复杂、多变的商业世界里,既维持技术竞争力,又完成商业落地?

    《对话 Momenta 曹旭东:超越智驾的摩尔定律》

    两年前的专访我们也发过播客,可见《晚点聊》77 期。那一次我们更多聊了具体方法论。

    这一次发生在 IPO 前后的专访,我与曹旭东聊了他的思考和判断方式如何形成,和下一个十年,他面向具身智能和物理 AI 的推演。

    本期节目已发布图文版: 《Momenta IPO 后专访曹旭东:聪明人如何下笨功夫》

    本期嘉宾:
    曹旭东,Momenta 创始人
    本期主播:
    程曼祺,《晚点 LatePost》科技报道负责人

    时间线:

    -量产智驾的战争结束了
    03:54 什么叫“竞争结束”?改变格局的窗口正在关闭
    07:59 智驾从 nice to have 走到了 must have
    17:50 车企的竞争力不在于能做智驾

    -机器人和物理 AI:2030 会发生什么
    27:41 家庭场景拐点将至,R7 验证了世界模型
    34:54 同样创业十年的 Momenta 和宇树
    39:06 RoboVan > RoboTruck > RoboTaxi
    44:54 量产智驾、Robo 和机器人,世界模型是共同底座
    48:52 “规模不是我们思考的出发点”

    -当一个学物理的人想做 AI
    58:04 一旦思考起智能,停不下来
    01:04:55 从孙剑那儿学到的:超一流的人是聪明人下苦功夫
    01:09:09 加入商汤,十年前的 AI 赋能百业
    01:15:33 不再只是研究员:天性偏好、底层愿望
    01:20:27 创立 Momenta:感知和认知的结合点
    01:23:30 为什么十年前就看到“数据驱动”?
    01:29:12 数据驱动的推演:要量产,不要 Waymo

    -现在的“不复杂”,过去的“很痛苦”
    01:34:27 从一个研究院到真的创业公司
    01:38:46 从“血肉模糊”的首个客户到研发和交付的“主线原则”
    01:47:50 “相信”和“真的相信”不一样
    01:49:52 回到一线,回到一线,回到一线
    01:57:50 狐狸知道很多事,刺猬知道一件大事

    相关链接:

    《Momenta IPO 后专访曹旭东:聪明人如何下笨功夫》
    晚点聊 77 期:《不仅是车企的战争,与 Momenta 创始人曹旭东聊智驾供应商生存法》
    《对话 Momenta 曹旭东:超越智驾的摩尔定律》

    小红书@曼祺_火柴Q即刻@曼祺_火柴Q

    ☆《晚点聊 LateTalk》建立「 播客听友群」啦!☆

    欢迎关注科技、商业大公司动态和创业创新的小伙伴进群交流,第一时间收听新节目。
    这里有更多互动,更多话题讨论。欢迎贡献选题 & 推荐嘉宾。

    请先添加「晚点」小助手的微信号,备注:“晚点聊”,我们邀请您入群。

    关注公众号《晚点 LatePost》和《晚点对话》,阅读更多商业、科技文章:


    1 2 3 19 Next

    Related Podcasts

    How I Built This with Guy Raz

    1

    How I Built This with Guy Raz Business
    Planet Money

    2

    Planet Money Business
    Inside Strategic Coach: Connecting Entrepreneurs With What Really Matters

    3

    Inside Strategic Coach: Connecting Entrepreneurs With What Really Matters Business
    BiggerPockets Real Estate Podcast

    4

    BiggerPockets Real Estate Podcast Business
    The Smart Passive Income Online Business and Blogging Podcast

    5

    The Smart Passive Income Online Business and Blogging Podcast Business
    Bad With Money With Gabe Dunn

    6

    Bad With Money With Gabe Dunn Business
    footer-logo

    Contact Us

    Toll Free: 844-670-7747

    Links

    • Home
    • Top Charts
    • Networks
    • Apps
    • Independents Podcasts
    • Podcast Advertising
    • Podcast News
    • Contact Us
    • About Us
    • Analytics & Insights

    Stay Connected

      Privacy, Terms of Use & Our Code of Ethics Protecting Content Creators Copyrights